
Otimização de custos de LLM: como olhar para o Cache
 Níckolas Da Silva
Quando a conta de LLM começa a pesar, o primeiro reflexo é abrir a tabela de preços e procurar o modelo com o menor preço por milhão de tokens. Só que, se você usa agentes de código, esse número quase não diz nada. O que decide a sua conta é o cache de prompt: quanto da sua entrada já vem dele e quanto o modelo cobra por isso.
Um exemplo: um dia típico de trabalho com agente, no padrão que a gente vê na plataforma, tem uns 20 Mi de tokens de entrada, 99% deles vindos do cache, e 120 mil de saída. No GPT 6 Luna, esse dia sai por R$ 1,94; no DeepSeek V4.1 Flash, por R$ 2,21. No Qwen 3.6 27B, que cobra menos da metade do DeepSeek pela entrada, sai por R$ 18,24. E se esse mesmo DeepSeek não aproveitasse nada de cache, você pagaria R$ 42,60.1
Neste post, eu te mostro por que agentes dependem tanto do cache, em que ponto os modelos “baratos” deixam de ser baratos e como descobrir quanto cache você usa.
Por que agentes dependem muito de cache
Um agente não manda só a sua última mensagem. A cada turno, ele reenvia o prompt inteiro: system prompt, ferramentas, arquivos que já leu, saídas de comandos e todo o histórico. De um turno para o outro, só muda um pedaço pequeno no final.
Os provedores se aproveitam disso com o cache de prompt: se o começo da sua requisição (o prefixo) é idêntico ao de uma requisição recente, esses tokens saem do cache e custam bem menos. Só o trecho novo paga o preço cheio de entrada.
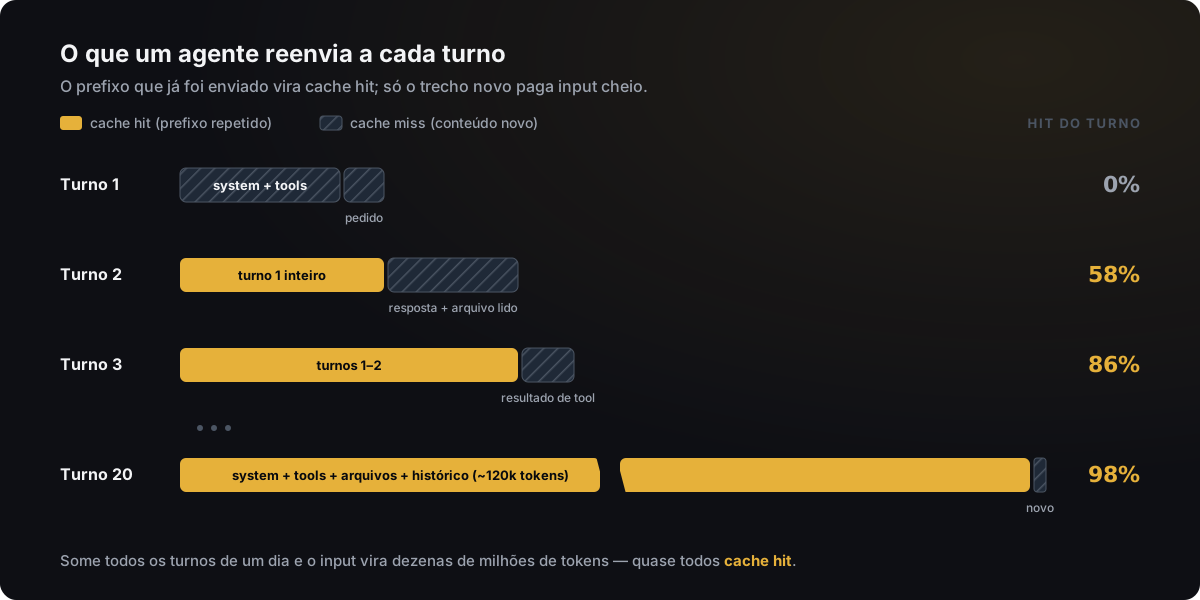
É exatamente isso que aparece nos dias de trabalho com agente que vemos na plataforma: cada requisição carrega algo entre 75 e 135 mil tokens de entrada e devolve só uns 500 a 600 tokens de saída, e de 90% a 99% dessa entrada vem do cache.
Somando todos os turnos de um dia típico, você chega ao nosso cenário de referência:
- 20 Mi de tokens de entrada no total;
- 200 mil deles fora do cache, ou seja, 19,8 Mi vindos do cache (99% de cache hit);
- 120 mil tokens de saída.
Nove modelos, o mesmo dia típico de agente
Veja quanto esse dia custa em cada modelo, com os preços do catálogo de modelos em 10/11/2026. A barra é o custo com 99% de cache hit; embaixo dela está o que você pagaria sem cache nenhum.
Ver os números em tabela
| Modelo | R$ por 1 Mi: entrada / saída / cache | Com cache | Sem cache |
|---|---|---|---|
| GPT 6 Luna | 0,69 / 3,47 / 0,07 | R$ 1,94 | R$ 14,22 |
| DeepSeek V4.1 Flash | 2,08 / 8,32 / 0,04 | R$ 2,21 | R$ 42,60 |
| GLM 5.3 Flash | 1,04 / 3,47 / 0,21 | R$ 4,78 | R$ 21,22 |
| Apiário Coder | 2 / 7 / 0,2 | R$ 5,20 | R$ 40,84 |
| Claude Haiku 5.5 | 3,47 / 17,33 / 0,35 | R$ 9,70 | R$ 71,48 |
| Gemma 4 12B | 0,75 / 0,85 / — | R$ 15,10 | R$ 15,10 |
| Qwen 3.6 27B | 0,85 / 10,3 / — | R$ 18,24 | R$ 18,24 |
| Qwen 3.8 27B (fp8) | 0,95 / 12,4 / — | R$ 20,49 | R$ 20,49 |
| Claude Sonnet 5.5 | 13,86 / 69,3 / 0,69 | R$ 24,75 | R$ 285,52 |
Olha o DeepSeek V4.1 Flash. A entrada cheia dele (R$ 2,08 por milhão) custa mais que o dobro da do Gemma 4 12B, o modelo mais barato da nossa tabela de preços, e da dos dois Qwen, mas a entrada que vem do cache sai a R$ 0,04, 52 vezes menos. Com 99% de cache, é esse o preço que importa, e o dia fica 6,8 vezes mais barato que no Gemma.
O GPT 6 Luna vai além: cobra R$ 0,07 pelo cache e fecha o dia em R$ 1,94, quase 8 vezes menos que o Gemma. Até o Claude Haiku 5.5 sai por R$ 9,70 e passa na frente do Gemma e dos dois Qwen.
Repare também no Claude Sonnet 5.5: o mesmo dia custa R$ 24,75 com cache e R$ 285,52 sem. Com cache, ele fica perto dos modelos “baratos” sem desconto nenhum. E isso não é exagero: já vimos na plataforma um único dia com um modelo premium e zero de cache custar mais que semanas de trabalho com agente num modelo com cache.
O outro lado: Qwen e Gemma
Se você olhar só o preço de entrada, Qwen 3.6 e Qwen 3.8 parecem pechinchas: R$ 0,85 e R$ 0,95 por milhão. Só que eles não oferecem preço reduzido para cache. Cada token que o agente relê no loop é cobrado cheio.
E o Qwen 3.6 perde do GPT 6 Luna mesmo com 0% de cache hit: a entrada do Luna já é mais barata (R$ 0,69 contra R$ 0,85), e a saída do Qwen custa três vezes mais (R$ 10,30 contra R$ 3,47). Sem cache nenhum, o dia de referência sai por R$ 18,24 no Qwen 3.6 e por R$ 14,22 no Luna. O Luna já começa na frente, antes de o cache entrar na conta.
O modelo barato sem cache de verdade é o Gemma 4 12B: R$ 0,75 de entrada e R$ 0,85 de saída. Com muita saída e pouco contexto repetido, é difícil batê-lo. Com agentes, ele perde para quase todos os modelos com cache.
A partir de quanto cache vale a pena
Para saber quando o cache compensa, vale comparar cada modelo com o mais barato da tabela de preços da plataforma hoje: o Gemma 4 12B, que cobra R$ 0,75 por milhão de entrada e R$ 0,85 de saída, sem preço reduzido para cache. A pergunta certa não é “qual é o mais barato?”, e sim “com quanto de cache hit o modelo passa a ganhar do Gemma?”. Como o custo varia em linha reta com o cache hit, dá para calcular o ponto exato do empate: o ponto de virada.
Abaixo tem um gráfico por modelo, todos com o dia típico de agente (20 Mi de entrada e 120 mil de saída). O eixo de baixo é a taxa de cache hit, de 0% a 100%, e o da esquerda é quanto esse dia custa, em reais. A linha fina e plana é o Gemma: como ele não tem preço de cache, o dia custa R$ 15,10 com qualquer taxa, e tudo abaixo dela, na faixa “mais barato”, sai mais em conta. A linha amarela é o modelo do gráfico, e o ponto onde ela cruza a do Gemma é o ponto de virada: dali para a direita, o modelo ganha. A escala vai de R$ 0 a R$ 45 em todos os gráficos, para você comparar um com o outro; quando uma linha começa acima disso, uma setinha mostra onde ela entra.
Depois de cada gráfico, eu comento também uma tarefa com 10 tokens de entrada para cada token de saída, como 2 Mi de entrada e 200 mil de saída. Com mais saída na conta, o cache pesa menos, e o ponto de virada fica mais longe ou some.
GPT 6 Luna: mais barato até sem cache
- GPT 6 Luna: já ganha em 0%
- Gemma 4 12B: R$ 15,10 (sem preço de cache)
O GPT 6 Luna é o único que já ganha do Gemma sem cache nenhum: o dia sai por R$ 14,22, contra R$ 15,10, porque a entrada cheia dele (R$ 0,69 por milhão) é um pouco mais barata que a do Gemma e quase tudo nesse dia é entrada. Com 100% de cache, a R$ 0,07, ele cai para R$ 1,82. Numa tarefa 10:1, a saída pesa mais, e a do Luna custa quatro vezes a do Gemma (R$ 3,47 contra R$ 0,85): aí ele só empata com 32,6% de cache hit.
GLM 5.3 Flash: empata com pouco cache
- GLM 5.3 Flash: empata em 36,8%
- Gemma 4 12B: R$ 15,10 (sem preço de cache)
O GLM 5.3 Flash começa atrás: sem cache, o dia sai por R$ 21,22, porque a entrada cheia custa R$ 1,04. Mas o cache sai a R$ 0,21, e com 36,8% de cache hit ele já empata; com 100%, o dia fica em R$ 4,62. Numa tarefa 10:1, a saída de R$ 3,47 pesa mais e o empate só vem com 66,5%, uma taxa que um agente passa com folga.
DeepSeek V4.1 Flash: caro sem cache, barato com
- DeepSeek V4.1 Flash: empata em 67,4%
- Gemma 4 12B: R$ 15,10 (sem preço de cache)
O DeepSeek V4.1 Flash começa bem mais caro: sem cache, o dia sai por R$ 42,60, quase o triplo do Gemma, porque a entrada cheia custa R$ 2,08. Como o cache custa só R$ 0,04, a linha despenca, cruza a do Gemma com 67,4% de cache hit e chega a R$ 1,80 com 100%. Numa tarefa 10:1, ele nunca empata: mesmo com 100% de cache, a tarefa sai por R$ 1,74, contra R$ 1,67 no Gemma, por causa da saída de R$ 8,32 por milhão, quase dez vezes a do Gemma.
Apiário Coder: precisa de mais cache que o DeepSeek
- Apiário Coder: empata em 71,5%
- Gemma 4 12B: R$ 15,10 (sem preço de cache)
O Apiário Coder tem um desenho parecido: sem cache, o dia sai por R$ 40,84. Só que o cache dele custa cinco vezes o do DeepSeek (R$ 0,20 contra R$ 0,04), então a linha desce menos: o empate só vem com 71,5% de cache hit, e com 100% o dia fica em R$ 4,84. Numa tarefa 10:1, nem 100% de cache resolve: ele fica em R$ 1,80, contra R$ 1,67 no Gemma, puxado pela saída de R$ 7,00.
Claude Haiku 5.5: empata raspando
- Claude Haiku 5.5: empata em 90,3%
- Gemma 4 12B: R$ 15,10 (sem preço de cache)
O Claude Haiku 5.5 é o último a empatar. Sem cache, o dia sai por R$ 71,48, quase cinco vezes o Gemma e acima da escala, porque a entrada cheia custa R$ 3,47; o cache (R$ 0,35) ainda custa perto da metade da entrada do Gemma, então o empate só vem com 90,3% de cache hit, e com 100% o dia fica em R$ 9,08. Como os dias de agente que vemos na plataforma ficam entre 90% e 99% de cache hit, ele passa na maioria dos dias, mas não em todos. Numa tarefa 10:1, nunca empata: com a saída a R$ 17,33, mesmo com 100% de cache ele custa 2,5 vezes o Gemma.
Claude Sonnet 5.5: nunca empata
- Claude Sonnet 5.5: nunca empata
- Gemma 4 12B: R$ 15,10 (sem preço de cache)
O Claude Sonnet 5.5 nunca empata. Sem cache, o dia sai por R$ 285,52, quase 19 vezes o Gemma e bem acima da escala; com 100% de cache, ainda fica em R$ 22,12. O cache dele (R$ 0,69) custa menos que a entrada cheia do Gemma, mas a saída sai a R$ 69,30 por milhão, mais de 80 vezes a do Gemma. Numa tarefa 10:1, ele custa 9,1 vezes o Gemma mesmo com 100% de cache. Cache barato não salva saída cara.
Qwen 3.6 27B: o cache não muda nada
- Qwen 3.6 27B: nunca empata
- Gemma 4 12B: R$ 15,10 (sem preço de cache)
Os dois Qwen não têm preço reduzido para cache, então as linhas são planas: o cache hit não muda nada. O Qwen 3.6 27B fecha o dia em R$ 18,24 com qualquer taxa, porque a entrada dele (R$ 0,85) já é um pouco mais cara que a do Gemma e a saída (R$ 10,30) custa doze vezes mais. Numa tarefa 10:1, essa saída pesa ainda mais, e ele custa 2,3 vezes o Gemma.
Qwen 3.8 27B (fp8): o mesmo, um pouco mais caro
- Qwen 3.8 27B (fp8): nunca empata
- Gemma 4 12B: R$ 15,10 (sem preço de cache)
Ver todos os pontos de virada em tabela
| Modelo | Sem cache | 100% de cache | Virada: dia típico de agente | Virada: tarefa 10:1 |
|---|---|---|---|---|
| GPT 6 Luna | R$ 14,22 | R$ 1,82 | já ganha em 0% | 32,6% |
| GLM 5.3 Flash | R$ 21,22 | R$ 4,62 | 36,8% | 66,5% |
| DeepSeek V4.1 Flash | R$ 42,60 | R$ 1,80 | 67,4% | nunca |
| Apiário Coder | R$ 40,84 | R$ 4,84 | 71,5% | nunca |
| Claude Haiku 5.5 | R$ 71,48 | R$ 9,08 | 90,3% | nunca |
| Claude Sonnet 5.5 | R$ 285,52 | R$ 22,12 | nunca | nunca |
| Qwen 3.6 27B | R$ 18,24 | R$ 18,24 | nunca | nunca |
| Qwen 3.8 27B (fp8) | R$ 20,49 | R$ 20,49 | nunca | nunca |
O Qwen 3.8 27B (fp8) segue o mesmo desenho, só que um pouco mais caro: R$ 20,49 no dia, com qualquer taxa de cache, e 2,6 vezes o Gemma numa tarefa 10:1.
Repare que, em todos os modelos, a tarefa 10:1 empata mais tarde que o dia típico de agente, ou nem empata. A tabela no fim do último gráfico junta os dois cenários. O ponto de virada depende da proporção entre entrada e saída, não do volume: uma tarefa com 2 Mi de entrada e 200 mil de saída e outra com 500 mil e 50 mil empatam no mesmo ponto, porque as duas têm 10 tokens de entrada para cada token de saída. No dia típico de agente, são mais de 160 para 1. Quanto mais entrada relida por token gerado, mais cedo o cache compensa.
E a qualidade?
Pela conta, os gráficos deixam claro que os modelos Claude não compensam no dia típico de agente: o Claude Sonnet 5.5 nunca empata com o Gemma, e o Claude Haiku 5.5 só empata raspando. Mas preço não é a única coisa que importa na hora de escolher um modelo.
Entre os modelos baratos, o Qwen também não leva vantagem em qualidade. Nos números publicados pelos desenvolvedores, o GPQA Diamond fica em 90,9 no DeepSeek V4.1 Flash (modelo instruct, esforço máximo), 87,8 no Qwen 3.6 27B, 89,2 no Qwen 3.8 27B e 78,8 no Gemma 4 12B. Cada empresa mede do seu jeito, então use esses números como ordem de grandeza, não como ranking.
A força dos modelos Claude está na inteligência. No índice de inteligência da Artificial Analysis, que junta várias avaliações independentes, o Claude Sonnet 5.5 no esforço máximo marcava 56 em outubro de 2026, bem à frente do Claude Haiku 5.5 (43), do GLM 5.3 Flash (42) e do GPT 6 Luna (38). Quando a tarefa pede raciocínio difícil, é por essa diferença que você paga a mais. Para o trabalho do dia a dia, em que um modelo mais barato dá conta do recado, quem manda na conta continua sendo o cache.
Tarefas com muito cache e tarefas com pouco
A taxa de cache hit não é uma característica do modelo, e sim da sua tarefa. Algumas tarefas se repetem por natureza:
- Agente de código numa sessão longa, que reenvia tudo a cada turno.
- Refatoração em vários arquivos, relendo os mesmos módulos.
- Ciclo de TDD: testa, lê a falha, corrige, sempre no mesmo contexto.
- Revisão do mesmo PR várias vezes: só a pergunta muda.
Outras quase não repetem nada:
- Classificação em lote de tickets ou comentários curtos.
- Geração avulsa, como descrições de produto ou e-mails.
- Resumo de documentos sem relação entre si.
- Extração de dados de notas fiscais, contratos ou formulários.
Na plataforma, automações e processamento em lote têm outra cara: cada requisição leva uns 3 mil tokens de entrada e devolve perto de mil de saída, e só 10% a 25% da entrada vem do cache. Comparando com o agente, cada requisição carrega dezenas de vezes menos entrada, mas devolve bem mais saída.
Por isso, número de requisições é a unidade errada para pensar em custo. Uma automação que faz centenas de requisições por dia pode custar menos que um agente que faz algumas dezenas. O que pesa é quantos tokens cada requisição carrega, quanto deles vem do cache e quanto sai de resposta.
Só um cuidado: se a sua classificação em lote começa com um bloco enorme e fixo de exemplos, ela passa a usar muito cache, porque esse prefixo se repete em todo item.
Na prática: se a maior parte da sua entrada é releitura, escolha o modelo pelo preço da entrada em cache e da saída. Se cada requisição é nova, escolha pela entrada cheia e pela saída.
Como descobrir quanto cache você usa
Para prever a conta, você precisa de três números: entrada total, entrada que veio do cache e saída. Sem eles, qualquer comparação de preço é chute.
- No painel de uso, cada modelo tem uma linha com as colunas Requisições, Entrada, Saída e Cache: quantas chamadas você fez, os tokens que mandou, os que recebeu e quantos dos de entrada vieram do cache. A Entrada já inclui o que veio do cache, então o que ficou fora do cache é a diferença entre as duas.
- Uma regra de bolso: divida a Entrada pelas Requisições. Se der dezenas de milhares de tokens por requisição, você depende de cache. Se der poucos milhares, o que pesa na conta é o preço de saída.
- O painel agrupa o uso pelo modelo que você pediu. Para comparar modelos, compare essas linhas entre si.
- Os preços de entrada, de cache e de saída de cada modelo estão no catálogo de modelos. Quando um modelo não mostra preço de cache, cada token de entrada é cobrado cheio, venha ou não do cache.
Pegue uma semana do seu uso real, veja no painel quanto da sua entrada veio do cache e compare com os pontos de virada dos gráficos acima: se a sua taxa passa do ponto de um modelo, ele sai mais barato que o Gemma para você.
Como olhar para o cache, em três perguntas
Antes de comparar preço por token, responda:
- Quanto da minha entrada já vem do cache? Olhe a Entrada e o Cache no painel de uso. Com agentes de código, em que quase toda entrada é releitura, isso passa fácil de 90%.
- Quanto o modelo cobra pelo cache? Com muito cache, quem manda é esse preço, e modelos como GPT 6 Luna, DeepSeek V4.1 Flash, GLM 5.3 Flash e Apiário Coder custam uma fração do que custam os modelos sem cache.
- A partir de quanto cache ele compensa? É o ponto de virada que você viu nos gráficos. Para tarefas avulsas e com muita saída, em que quase nada vem do cache, o Gemma 4 12B leva a melhor. E o Qwen 3.6, que parece barato pelo preço de entrada, perde nos dois casos.
Quer descobrir como é o seu uso? Crie sua conta no Apiário Dev, use os modelos por alguns dias e abra o painel de uso para ver quanto da sua entrada já vem do cache. 🐝
Notas
-
Os valores em reais do texto e dos gráficos usam os preços de 10/11/2026. Preço muda; confira os atuais no catálogo de modelos. ↩
Comece a usar o Apiário Dev
Crie sua conta e acesse dezenas de modelos de IA em uma API compatível com OpenAI. Pré-pago, sem pagamento recorrente: pague apenas pelo que usar.
Começar agora